Distribusi Normal, Galat Baku, dan Interval Kepercayaan
Modul 4 · Biostatistik · Semester Ganjil 2026/2027
Program Studi D4 Teknologi Laboratorium Medik, Universitas Syedza Saintika
Daftar bagian
Tujuan belajar
Setelah modul ini, Anda mampu:
- Menjelaskan sifat distribusi normal dan aturan 68-95-99,7.
- Menghitung dan menafsirkan skor z.
- Membedakan parameter (populasi) dan statistik (sampel).
- Menjelaskan distribusi sampling dan galat baku (SE).
- Menghitung dan menafsirkan interval kepercayaan 95% dengan benar.
Modul ini adalah jembatan dari statistik deskriptif ke statistik inferensial. Luangkan waktu lebih lama di sini.
Distribusi normal
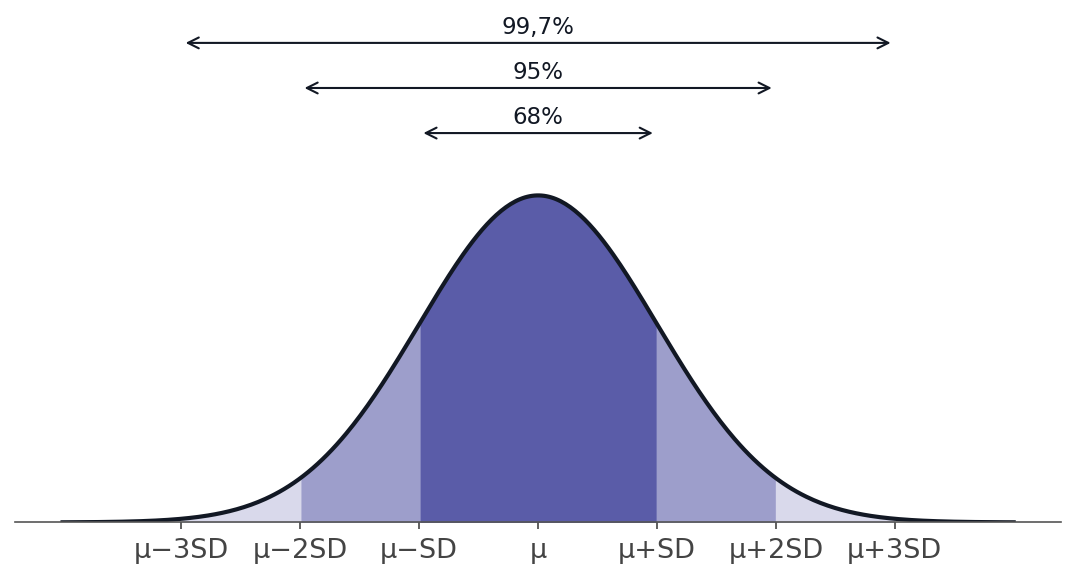
- Berbentuk lonceng, simetris, rerata = median = modus, ditentukan oleh μ dan σ.
- Sekitar 68% data dalam μ ± 1 SD, 95% dalam μ ± 2 SD (tepatnya 1,96 SD), 99,7% dalam μ ± 3 SD.
Di mana Anda sudah bertemu kurva ini?
Grafik Levey-Jennings (QC)
- Garis tengah = rerata bahan kontrol
- Garis ±2 SD = batas peringatan (1₂s)
- Garis ±3 SD = batas tolak (1₃s)
Jika proses stabil, hanya sekitar 5% titik yang keluar dari ±2 SD karena kebetulan.
Nilai rujukan
- Dibuat dari orang sehat
- Mengambil 95% bagian tengah
- Artinya 5% orang sehat akan mendapat hasil “di luar rujukan”
Pedoman CLSI EP28 menganjurkan minimal 120 subjek rujukan per kelompok.
(Clinical and Laboratory Standards Institute, 2010; Westgard dkk., 1981)
Contoh: rentang ±2 SD dari dataset
Hb perempuan pada dataset berjalan: rerata 13,05 g/dL, SD 1,08 g/dL (n = 28).
13{,}05 \pm 2 \times 1{,}08 = 10,89 sampai 15,21 g/dL
Ini hanya latihan cara berpikir. Rentang ini tidak boleh dipakai sebagai nilai rujukan, karena:
- n = 28 jauh di bawah 120,
- subjek belum tentu sehat,
- belum dicek apakah datanya benar-benar normal.
Skor z: seberapa jauh dari rerata?
z = \frac{x - \bar{x}}{s}
Skor z mengubah nilai apa pun menjadi “berapa SD dari rerata”.
Contoh: subjek perempuan dengan Hb 10,8 g/dL.
z = (10{,}8 - 13{,}05) / 1{,}08 = -2{,}25 / 1{,}08 = −2,08
Nilainya lebih dari 2 SD di bawah rerata kelompoknya. Pada distribusi normal, kurang dari 2,5% nilai berada serendah ini.
Di QC, skor z dipakai untuk menilai hasil uji profisiensi (PME): |z| ≤ 2 memuaskan, 2 < |z| < 3 peringatan, |z| ≥ 3 tidak memuaskan.
(International Organization for Standardization, 2022)
Tidak semua data normal
Ingat modul 3: gula darah puasa menceng ke kanan, Hb hampir simetris.
Cara memeriksa normalitas (detail di Modul 8):
- Lihat histogram dan Q-Q plot. Selalu langkah pertama.
- Bandingkan rerata dan median. Jauh berbeda berarti menceng.
- Uji Shapiro-Wilk (paling dianjurkan, terutama untuk sampel kecil sampai sedang) atau Kolmogorov-Smirnov.
| Variabel dataset | Rerata | Median | Shapiro-Wilk p |
|---|---|---|---|
| Hb | 14,05 | 13,95 | 0,748 |
| Gula darah puasa | 100,8 | 94,5 | < 0,001 |
Nilai p > 0,05 berarti tidak ada bukti data menyimpang dari normal. Makna nilai p dibahas di modul 7.
(Ghasemi & Zahediasl, 2012; Shapiro & Wilk, 1965)
Populasi dan sampel
Kita hampir tidak pernah bisa memeriksa seluruh populasi. Kita menebak populasi dari sampel. Seberapa bagus tebakan itu?
Parameter dan statistik
| Populasi | Sampel | |
|---|---|---|
| Disebut | parameter | statistik |
| Rerata | μ (mu) | \bar{x} |
| Simpangan baku | σ (sigma) | s |
| Proporsi | π atau P | p |
| Diketahui? | hampir tidak pernah | ya, kita hitung |
Statistik inferensial adalah seni menebak parameter dari statistik, sekaligus menyatakan seberapa besar kemungkinan tebakan itu meleset.
Eksperimen pikiran
Bayangkan populasi gula darah puasa satu kota. Anda mengambil sampel 5 orang, menghitung reratanya, lalu mengulang 5.000 kali.
Apakah 5.000 rerata itu akan sama?
Tidak. Setiap sampel memberi rerata sedikit berbeda. Kumpulan rerata dari sampel berulang ini disebut distribusi sampling rerata.
Distribusi sampling rerata
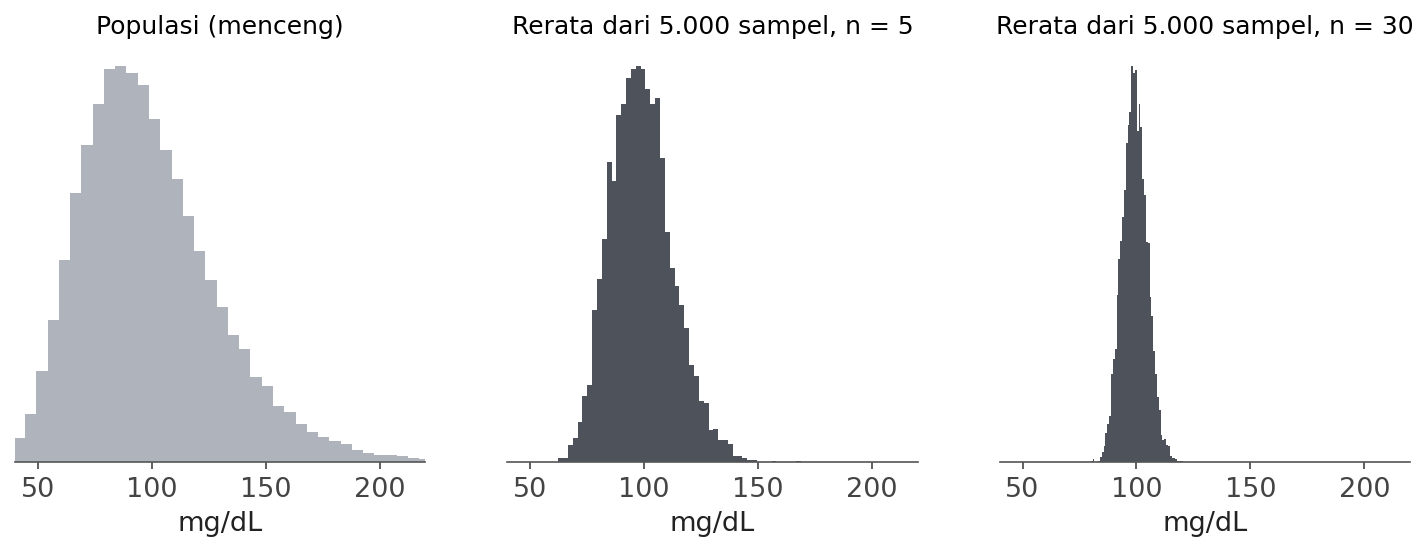
- Populasi menceng, tetapi rerata sampel makin simetris seiring n bertambah (Teorema Limit Pusat).
- Makin besar n, sebaran rerata makin sempit: SD populasi ≈ 30,4; n = 5 ≈ 13,6; n = 30 ≈ 5,5 mg/dL.
Galat baku (standard error, SE)
Sebaran distribusi sampling rerata disebut galat baku:
SE = \frac{s}{\sqrt{n}}
- SE mengukur seberapa jauh rerata sampel biasanya meleset dari rerata populasi.
- Untuk memperkecil SE setengahnya, n harus dinaikkan empat kali lipat.
Contoh: Hb seluruh dataset, s = 1,45 g/dL, n = 60.
SE = 1{,}45 / \sqrt{60} = 1{,}45 / 7{,}75 = 0,187 g/dL
Interval kepercayaan 95% (IK 95%)
IK\ 95\% = \bar{x} \pm t \times SE
Nilai t diambil dari tabel distribusi t dengan derajat bebas n − 1. Untuk n besar, t mendekati 1,96.
Contoh: Hb seluruh dataset. \bar{x} = 14,05; SE = 0,187; t_{59} = 2,001.
14{,}05 \pm 2{,}001 \times 0{,}187 = 14{,}05 \pm 0{,}37
IK 95%: 13,67 sampai 14,42 g/dL
Makna IK 95% yang benar
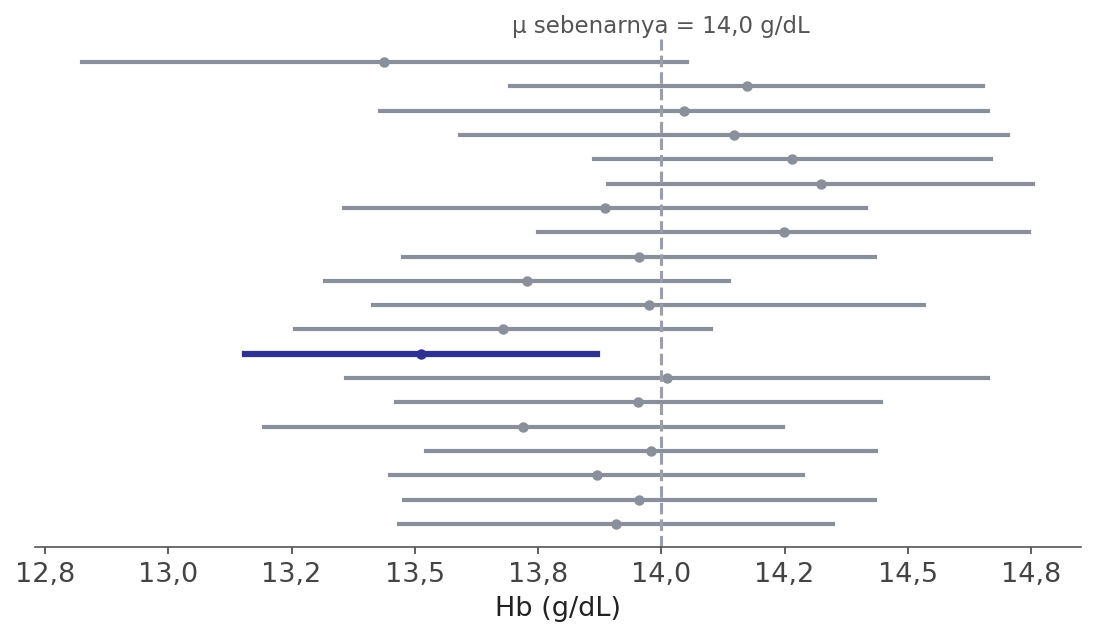
Dua puluh sampel (n = 30) dari populasi dengan μ = 14,0. Setiap garis adalah satu IK 95%. Satu dari dua puluh (garis biru tebal) tidak mencakup μ.
Menafsirkan IK dengan tepat
| Benar | Salah |
|---|---|
| “Jika penelitian diulang berkali-kali, sekitar 95% interval yang dihasilkan akan mencakup rerata populasi.” | “Ada peluang 95% rerata populasi berada di antara 13,67 dan 14,42.” |
| “Kami 95% yakin rerata Hb populasi berada antara 13,67 dan 14,42 g/dL.” (bahasa sehari-hari yang diterima) | “95% subjek memiliki Hb antara 13,67 dan 14,42.” |
Kesalahan kolom kanan bawah paling sering terjadi: IK membicarakan rerata, bukan individu. Rentang untuk individu adalah rerata ± 2 SD, bukan IK.
Mengapa IK penting untuk skripsi Anda
- IK menunjukkan ketelitian hasil. IK yang lebar berarti hasil Anda kurang pasti.
- Sampel kecil menghasilkan SE besar, sehingga IK lebar.
| Kelompok | n | Rerata Hb | SE | IK 95% |
|---|---|---|---|---|
| Laki-laki | 32 | 14,92 | 0,200 | 14,52 sampai 15,33 |
| Perempuan | 28 | 13,05 | 0,205 | 12,63 sampai 13,47 |
Kedua IK tidak tumpang tindih. Ini isyarat awal bahwa rerata Hb kedua kelompok memang berbeda. Uji formalnya dibahas di Modul 9.
Latihan 1
Hitung skor z untuk subjek laki-laki dengan Hb 17,8 g/dL. Gunakan rerata 14,92 dan SD 1,13.
Jawaban: z = (17{,}8 - 14{,}92) / 1{,}13 = 2{,}88 / 1{,}13 = 2,55. Lebih dari 2 SD di atas rerata kelompoknya, layak diperiksa ulang (misalnya kemungkinan polisitemia atau hemokonsentrasi).
Latihan 2
Kreatinin 25 pasien: rerata 1,20 mg/dL, SD 0,30 mg/dL. Nilai t_{24} = 2,064.
Hitung SE dan IK 95%.
Jawaban:
SE = 0{,}30 / \sqrt{25} = 0{,}30 / 5 = 0,060
IK = 1{,}20 \pm 2{,}064 \times 0{,}060 = 1{,}20 \pm 0{,}124
IK 95%: 1,08 sampai 1,32 mg/dL
Latihan 3
Jika penelitian latihan 2 diulang dengan 100 pasien (SD tetap 0,30), apa yang terjadi pada SE dan lebar IK?
Jawaban: SE = 0{,}30 / \sqrt{100} = 0{,}030, setengah dari sebelumnya. IK menjadi sekitar setengah lebar semula (kurang lebih 1,14 sampai 1,26). Empat kali sampel, dua kali lebih teliti.
Ringkasan
- Distribusi normal: simetris, 68-95-99,7. Dasar QC dan nilai rujukan.
- Skor z = jarak dari rerata dalam satuan SD.
- Rerata sampel bervariasi dari sampel ke sampel: distribusi sampling.
- SE = s / √n mengukur ketelitian rerata; SD mengukur sebaran individu.
- IK 95% = \bar{x} \pm t \times SE; membicarakan rerata populasi, bukan individu.
- Sampel kecil menghasilkan IK lebar, artinya kesimpulan kurang pasti.
Daftar Pustaka
Selesai: Modul 4
Biostatistik · Prodi D4 TLM · Universitas Syedza Saintika