Statistik Deskriptif dan Penyajian Data
Modul 3 · Biostatistik · Semester Ganjil 2026/2027
Program Studi D4 Teknologi Laboratorium Medik, Universitas Syedza Saintika
Daftar bagian
Tujuan belajar
Setelah modul ini, Anda mampu:
- Menyajikan data kategorik dengan frekuensi dan persen.
- Menghitung rerata, median, simpangan baku (SD), dan rentang interkuartil (IQR) secara manual.
- Memilih antara rerata ± SD dan median (Q1 sampai Q3).
- Membaca histogram dan boxplot.
- Menghitung CV% untuk data presisi laboratorium.
- Memeriksa konsistensi data sebelum menulis BAB IV.
Dua jenis data, dua cara merangkum
| Data | Ringkasan | Grafik |
|---|---|---|
| Kategorik (nominal, ordinal) | frekuensi (n) dan persen (%) | diagram batang |
| Numerik (interval, rasio) | ukuran pemusatan + ukuran sebaran | histogram, boxplot |
Kesalahan umum: menghitung “rerata jenis kelamin” atau membuat histogram untuk data nominal.
Data kategorik: frekuensi dan persen
Dari dataset berjalan (n = 60):
| Variabel | Kategori | n | % |
|---|---|---|---|
| Status merokok | Merokok | 17 | 28,3 |
| Tidak | 43 | 71,7 | |
| Kategori IMT | Kurus | 6 | 10,0 |
| Normal | 22 | 36,7 | |
| Gemuk | 15 | 25,0 | |
| Obesitas | 17 | 28,3 |
Cek wajib: jumlah n dalam satu variabel harus sama dengan total sampel, dan persennya berjumlah 100% (boleh 99,9 atau 100,1 karena pembulatan).
Data numerik: pemusatan dan sebaran
Satu angka tidak cukup. Kita perlu tahu di mana pusatnya dan seberapa lebar sebarannya.
Ukuran pemusatan
- Rerata (mean): jumlah semua nilai dibagi banyaknya data. \bar{x} = \frac{\sum x_i}{n}
- Median: nilai tengah setelah data diurutkan. Jika n genap, rerata dua nilai tengah.
- Modus: nilai yang paling sering muncul (jarang dipakai untuk data kontinu).
Sifat penting: rerata terpengaruh nilai ekstrem, median tidak.
Ukuran sebaran
- Rentang (range): maksimum dikurangi minimum. Sangat sensitif terhadap satu nilai ekstrem.
- Simpangan baku (SD): rata-rata jarak data dari reratanya. s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n - 1}}
- Kuartil: Q1 (25% data di bawahnya), Q2 = median, Q3 (75% data di bawahnya).
- Rentang interkuartil (IQR) = Q3 dikurangi Q1, lebar 50% data bagian tengah.
Pasangan ukuran yang benar
Pasangan yang benar: rerata dengan SD, median dengan Q1 sampai Q3 (IQR). Jangan mencampur median dengan SD.
Hitung manual: lima nilai Hb
Data Hb (g/dL): 12,0; 13,0; 13,5; 14,0; 17,5
Rerata = 70,0 / 5 = 14,0
Median = nilai ke-3 = 13,5
Rentang = 17,5 − 12,0 = 5,5
| x_i | x_i - \bar{x} | kuadrat |
|---|---|---|
| 12,0 | −2,0 | 4,00 |
| 13,0 | −1,0 | 1,00 |
| 13,5 | −0,5 | 0,25 |
| 14,0 | 0,0 | 0,00 |
| 17,5 | 3,5 | 12,25 |
| jumlah | 17,50 |
Simpangan baku dari lima nilai Hb
s = \sqrt{17{,}50 / 4} = \sqrt{4{,}375} = 2,09 g/dL
Perhatikan: satu nilai 17,5 menarik rerata (14,0) ke atas median (13,5), dan menyumbang 12,25 dari 17,50 total kuadrat simpangan.
Mengapa pembaginya n − 1?
- Rumus SD sampel memakai n − 1, bukan n.
- Alasannya: kita memakai \bar{x} (dari sampel) sebagai pengganti rerata populasi yang tidak diketahui. Ini membuat simpangan terlihat sedikit lebih kecil dari seharusnya. Pembagi n − 1 mengoreksinya.
- Excel:
=STDEV.S()memakai n − 1 (benar untuk sampel).=STDEV.P()memakai n.
SPSS dan JASP otomatis memakai n − 1.
Bentuk distribusi: simetris
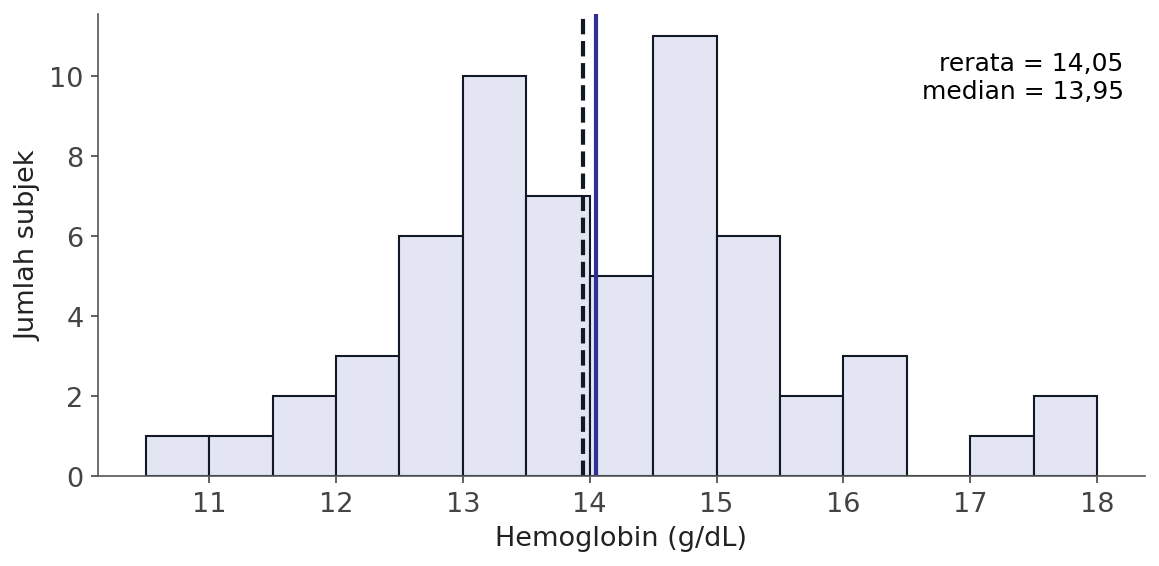
Hb pada dataset berjalan hampir simetris. Rerata (14,05) dan median (13,95) hampir sama. Laporkan rerata ± SD: 14,05 ± 1,45 g/dL.
Bentuk distribusi: menceng ke kanan
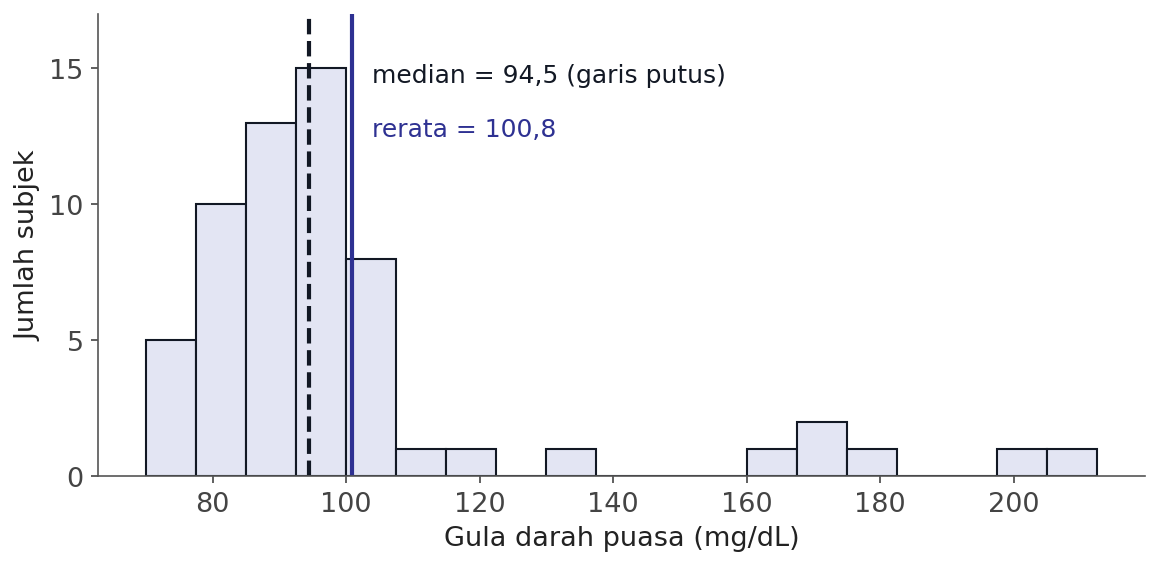
Gula darah puasa menceng ke kanan karena ada 7 subjek dengan GDP ≥ 126 mg/dL. Rerata (100,8) tertarik ke atas, median (94,5) lebih mewakili “subjek pada umumnya”.
Aturan memilih cara melaporkan
| Bentuk data | Laporkan | Contoh dari dataset |
|---|---|---|
| Kurang lebih simetris (normal) | rerata ± SD | Hb 14,05 ± 1,45 g/dL |
| Menceng atau ada nilai ekstrem | median (Q1 sampai Q3) | GDP 94,5 (84,8 sampai 101,0) mg/dL |
Cara memastikan bentuk distribusi (histogram, Q-Q plot, uji Shapiro-Wilk) dibahas di Modul 4 dan Modul 8. Untuk sekarang: selalu lihat histogramnya sebelum memilih.
Membaca boxplot
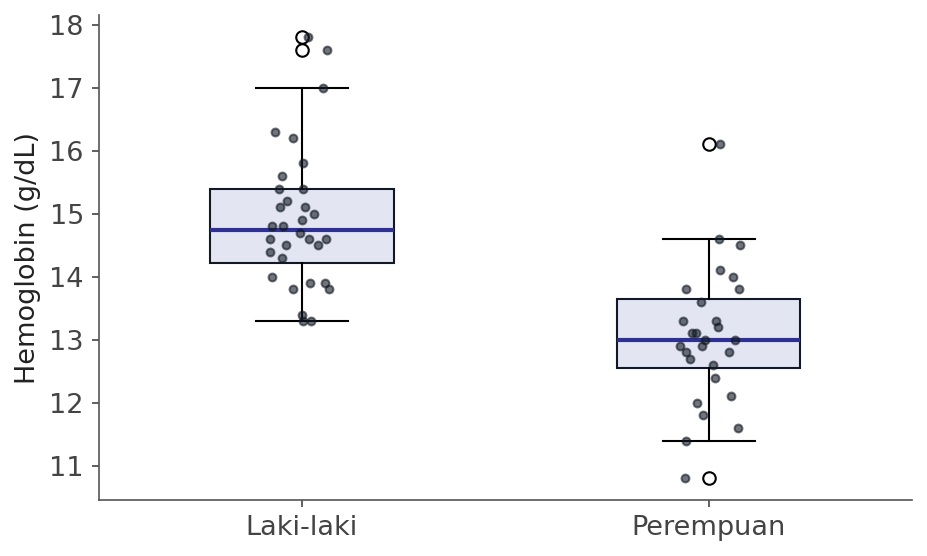
Membaca boxplot (lanjutan)
- Garis di dalam kotak = median
- Tepi kotak = Q1 dan Q3 (kotak = IQR)
- Garis kumis = data terjauh yang masih dalam 1,5 × IQR
- Lingkaran = nilai ekstrem (outlier)
Laki-laki: 14,92 ± 1,13 g/dL (n = 32)
Perempuan: 13,05 ± 1,08 g/dL (n = 28)
SD bukan SE
Mahasiswa sering tertukar antara simpangan baku (SD) dan galat baku (SE).
| SD | SE | |
|---|---|---|
| Menggambarkan | sebaran data individu | ketelitian rerata |
| Rumus | s | s / \sqrt{n} |
| Dipakai untuk | mendeskripsikan sampel | interval kepercayaan, uji |
SE selalu lebih kecil dari SD, sehingga tabel yang memakai “rerata ± SE” terlihat lebih “rapi”. Untuk deskripsi subjek, gunakan SD. SE dibahas mendalam di modul 4.
Koefisien variasi (CV%): statistik andalan laboratorium
CV\% = \frac{SD}{\bar{x}} \times 100
- CV% menyatakan sebaran relatif terhadap reratanya, sehingga presisi dua parameter dengan satuan berbeda bisa dibandingkan.
- Dipakai untuk uji presisi (repeatability, reproducibility) dan QC.
Contoh dari modul 1: Hb diperiksa 20 kali, rerata 13,44 g/dL, SD 0,14 g/dL.
CV\% = 0{,}14 / 13{,}44 \times 100 = 1,04%
Nilai ini dibandingkan dengan batas presisi yang diizinkan untuk parameter tersebut (misalnya dari spesifikasi pabrik atau data variasi biologis).
Contoh tabel karakteristik subjek (n = 60)
| Karakteristik | Nilai |
|---|---|
| Jenis kelamin, n (%) | |
| Laki-laki | 32 (53,3) |
| Perempuan | 28 (46,7) |
| Usia (tahun), rerata ± SD | 39,8 ± 12,3 |
| Hb (g/dL), rerata ± SD | 14,05 ± 1,45 |
| Gula darah puasa (mg/dL), median (Q1 sampai Q3) | 94,5 (84,8 sampai 101,0) |
| Hasil rapid reaktif, n (%) | 16 (26,7) |
Setiap baris menyebut satuan dan jenis ringkasan yang dipakai. Pembaca tidak perlu menebak.
Integritas data: pelajaran dari skripsi
Temuan yang sering muncul di naskah skripsi
- Nilai rerata kelompok tertukar antara abstrak dan tabel hasil.
- Total n di tabel tertulis 28, tetapi output SPSS 25.
- Rerata di tabel berbeda dari hasil hitung ulang data mentah di lampiran, karena salah konversi satuan atau rumus Excel yang salah rentang.
- Nilai MPV dua kelompok tertukar, baru ketahuan setelah dicocokkan dengan data mentah.
Semua kesalahan ini bukan kesalahan statistik yang sulit. Ini kesalahan ketelitian, dan bisa dicegah dengan daftar periksa.
Daftar periksa sebelum menulis BAB IV
- Satu baris satu subjek, satu kolom satu variabel. Tidak ada sel gabungan.
- Satuan setiap kolom tertulis di nama kolom (mis.
leukosit_10e3_ul). - Cek nilai minimum dan maksimum tiap variabel. Adakah nilai mustahil (Hb 145, usia 0)?
- Total n di setiap tabel sama dengan jumlah subjek yang dianalisis.
- Hitung ulang satu atau dua rerata secara manual dari data mentah.
- Cocokkan angka abstrak ↔︎ tabel ↔︎ narasi ↔︎ kesimpulan.
Latihan 1
Leukosit (×10³/µL) enam pasien: 7,8; 6,2; 11,9; 6,9; 7,1; 6,5
Hitung rerata, median, rentang, dan SD. Mana yang lebih tepat dilaporkan?
Latihan 1 (jawaban)
Jawaban:
- Urutkan: 6,2; 6,5; 6,9; 7,1; 7,8; 11,9
- Rerata = 46,4 / 6 = 7,73
- Median = (6,9 + 7,1) / 2 = 7,0
- Rentang = 11,9 − 6,2 = 5,7
- SD = 2,11
Nilai 11,9 menarik rerata ke atas dan membesarkan SD. Dengan data sekecil ini dan satu nilai ekstrem, median lebih mewakili.
Latihan 2
Seorang mahasiswa menulis:
“Rerata leukosit pasien adalah 17.571 sel/µL (leukositosis) dengan SD 6.976 sel/µL.”
Tabel alat menunjukkan hasil dalam satuan ×10³/µL, dengan angka seperti 17,6 dan 10,6. Apa yang salah?
Jawaban: Angka 17,571 berasal dari satuan ×10³/µL (artinya 17.571 sel/µL). Jika ditulis “17,571 sel/µL” dengan koma desimal, pembaca akan membaca 17 sel/µL, yang tidak masuk akal. Tuliskan satu format yang konsisten: 17,57 ×10³/µL, atau 17.571/µL. Periksa juga apakah nilai min-maks (10,6 sampai 37,3) memakai satuan yang sama.
Latihan 3
Hitung CV% dari data presisi glukosa berikut: rerata 102,0 mg/dL, SD 2,3 mg/dL.
Jawaban: CV\% = 2{,}3 / 102{,}0 \times 100 = 2,25%
Ringkasan
- Kategorik: n (%). Numerik: pemusatan + sebaran.
- Data simetris: rerata ± SD. Data menceng: median (Q1 sampai Q3).
- Rerata dan SD sensitif terhadap nilai ekstrem; median dan IQR tidak.
- SD menggambarkan data, SE menggambarkan ketelitian rerata.
- CV% adalah ukuran presisi utama di laboratorium.
- Ketelitian data (satuan, total n, kecocokan angka) sama pentingnya dengan pemilihan uji.
Selesai: Modul 3
Lanjut ke Modul 4: Distribusi Normal, Galat Baku, dan Interval Kepercayaan →
Biostatistik · Prodi D4 TLM · Universitas Syedza Saintika